Web to Publish med variabeldata: CSV-personalisering i stor skala
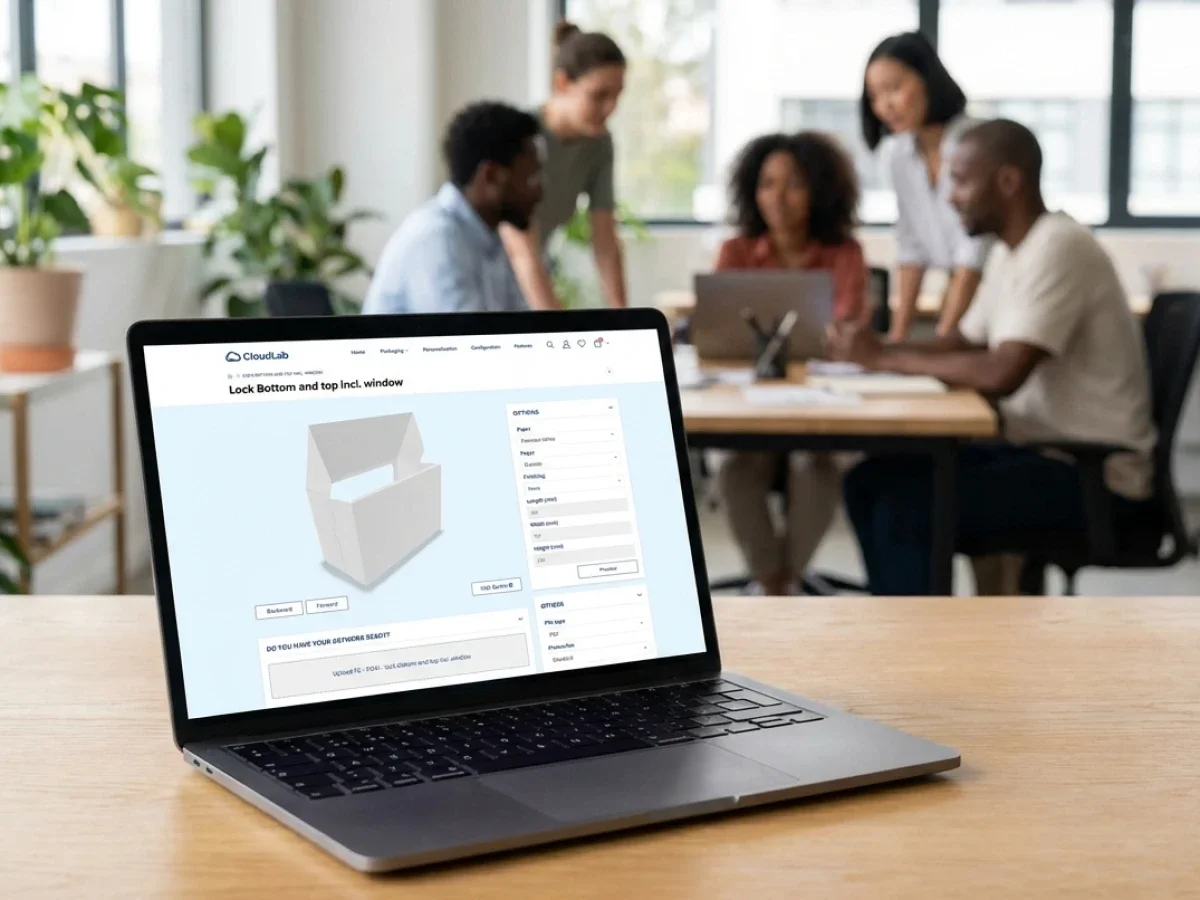
Web to Publish med variabeldata: Skapa personligt marknadsföringsmaterial effektivt med CSV-uppladdning
Personalisering innebär en operativ utmaning för företagsmarknadsföring. En kampanj kan använda ett centralt kreativt koncept, men organisationen behöver hundratals eller tusentals individuella versioner för olika filialer, säljare, franchisepartners, kunder, evenemang, produkter eller geografiska marknader. Designen förblir i stort sett identisk medan adresser, namn, kontaktuppgifter, bilder, erbjudanden, produktinformation, QR-koder eller annat innehåll ändras från version till version.
Att producera dessa varianter manuellt är svårt att motivera i stor skala. Designers eller byråer öppnar upprepade gånger samma original, ersätter ett begränsat antal fält, exporterar en ny version, döper om filen och fortsätter med nästa datapost. Marknadsföringsteam koordinerar kalkylblad och originalfiler, lokala användare granskar sina versioner och korrigeringar genererar ytterligare produktionscykler. Det kreativa värdet i arbetet är lågt, men den operativa arbetsbördan kan vara betydande.
Web to publish ändrar denna modell genom att separera den godkända designen från den variabla informationen. Central marknadsföring eller en byrå skapar en styrd mall en gång. Variabla fält definieras i mallen, medan varumärkeskritiska komponenter förblir skyddade. Strukturerad data kan sedan automatiskt fylla i dessa fält och förvandla en godkänd design till många personliga marknadsföringsmaterial.
En CSV-uppladdning är en praktisk mekanism för denna process eftersom många organisationer redan hanterar strukturerad marknadsföringsinformation i kalkylblad, CRM-exporter, ERP-data, evenemangslistor, filialdatabaser eller andra affärssystem. Istället för att kopiera varje post manuellt till en originalfil kan användare mappa relevanta kolumner till fördefinierade mallfält och generera personliga varianter systematiskt.
Effektivitetsvinsten är bara en del av värdet. Produktion med variabeldata skapar också en möjlighet till styrning. Om varje version genereras från samma godkända mall kan organisationer personalisera kommunikation utan att tillåta enskilda användare att ändra det underliggande materialet. Typografi, logotyper, layoutlogik, färger, obligatoriska element, bildytor och andra krav för visuell identitet förblir kontrollerade.
För komplexa organisationer bör dock personalisering via CSV inte bli ytterligare en isolerad produktionsprocess. Mallar behöver godkända tillgångar, definierade behörigheter, livscykelhantering, kampanjkontext, arbetsflödesregler och potentiellt efterföljande beställnings- eller distributionsprocesser. brandQ kopplar samman dessa krav inom en plattform för Enterprise Brand Management som kombinerar varumärkesportaler, digital tillgångshantering (DAM), hantering av marknadsföringsresurser, kampanjhantering, marknadsföringsautomation, styrning av visuell identitet, marknadsföringsinköp, evenemangshantering och flexibla godkännandeflöden.
Målet är därför inte bara att skapa fler versioner snabbare. Det handlar om att etablera en repeterbar process där personlig marknadsföring kan skalas upp utan att skapa samma tillväxt i manuell produktionsinsats, koordinering eller varumärkesrisk.
Varför Web to Publish blir värdefullt när personaliseringsvolymerna ökar
Affärsnyttan med produktion av variabeldata blir oftast synlig när organisationer granskar hur mycket repetitivt arbete som döljer sig i till synes enkla marknadsföringsförfrågningar. En säljorganisation kan behöva en broschyr personaliserad för varje säljare. Ett filialnätverk kan kräva affischer med lokala adresser och öppettider. En franchisekampanj kan behöva hundratals material med platsspecifik kontaktinformation. Ett evenemangsprogram kan kräva personliga deltagardokument.
Varje variant kan vara enkel, men volymen förändrar ekonomin. Om en designer bara behöver några minuter för att skapa och exportera en version, förbrukar hundratals varianter fortfarande många timmars produktionskapacitet. Ytterligare tid krävs för att ta emot data, validera ändringar, koordinera korrigeringar, överföra filer och bekräfta att rätt version når rätt mottagare.
Manuella processer skapar också inkonsekvens. Olika personer kan ange samma information i olika format. Ett telefonnummer kan följa en konvention i en fil och en annan någon annanstans. Långa namn kan bryta en fördefinierad layout. Gamla kontakt uppgifter kan kopieras från tidigare material. Ett lokalt team kan ändra mer än vad som ursprungligen var tänkt eftersom de får en redigerbar källfil.
Mallar för variabeldata skapar en annan produktionslogik. Istället för att behandla varje utdata som ett individuellt designjobb, behandlar organisationen det som en kombination av en godkänd mall och en validerad datapost. Det kreativa arbetet förblir centraliserat där professionell expertis tillför värde; repetitiv datainmatning automatiseras.
CSV-filer är särskilt användbara när personalisering behöver ske i batchar. En enskild fil kan innehålla en rad per mottagare, filial, plats, säljare, produkt eller evenemang. Kolumner representerar den variabla information som krävs av mallen. När dessa fält har mappats korrekt kan samma regler tillämpas konsekvent över hela datasetet.
Resultatet är en mer förutsägbar process. Marknadsavdelningen vet vilken mall som styr designen. Dataägare vet vilken information som driver personaliseringen. Lokala team får utdata skapad enligt samma regler. Ledningen får en modell som kan skalas bortom enskilda designers kapacitet.
Där manuell produktion av variabeldata skapar operativa risker
Det mest uppenbara problemet med manuell personalisering är arbetsbelastningen, men de större riskerna kommer ofta från fragmenterat ansvar. Marknadsavdelningen äger kampanjen, en byrå äger originalet, säljavdelningen äger kund informationen, regionala team underhåller platsuppgifter och IT hanterar systemen som innehåller masterdata. Utan en strukturerad process flyttas information mellan dessa grupper via kalkylblad, e-postbilagor och enskilda förfrågningar.
Varje överlämning skapar utrymme för fel. En föråldrad CSV-fil kan komma att användas i produktionen. Kolumner kan tolkas felaktigt. Data kan kopieras in i fel original. En reviderad mall kanske inte når alla som producerar lokala versioner. Korrigeringar som görs i ett utkast kanske inte tillämpas konsekvent på resten av batchen.
Godkännandeprocesser blir svåra när volymerna ökar. Att granska tio personaliserade versioner manuellt kan vara realistiskt. Att granska tusen versioner individuellt är det oftast inte. Organisationer ställs då inför ett obekvämt val mellan att skapa en flaskhals för godkännanden eller att minska kontrollen.
Decentraliserad produktion innebär ytterligare en risk. När lokalkontor eller säljteam inte kan få fram personaliserat material tillräckligt snabbt, kan de skapa egna versioner. Detta kan lösa ett omedelbart operativt behov, men samtidigt leda till inkonsekvent varumärkesprofilering, föråldrat innehåll, okontrollerade filer och begränsad insyn för huvudkontoret.
Vilka problem löser Web to publish med variabeldata inom decentraliserad marknadsföring?
Den största utmaningen är att personaliserad marknadsföring kombinerar stor variation i innehåll med krav på konsekvent design och tillförlitlig data. Web to publish minskar denna konflikt genom att separera skyddad mallogik från variabel information, vilket gör att mycket personaliserat material kan genereras utan att den underliggande designen behöver återskapas eller redigeras manuellt.
För marknadsföring och företagskommunikation minskar detta repetitiv produktion av original och skapar en mer konsekvent kampanjprocess. Centrala team definierar mallen, redigerbara fält, godkända tillgångar och innehållsregler en gång. En strukturerad CSV kan sedan tillhandahålla variabla värden för många utdata, samtidigt som företagets design förblir styrd.
För säljare, franchisepartners och lokala organisationer minskar processen väntetid och osäkerhet. Istället för att begära varje personaliserad version från huvudkontoret kan användare arbeta inom en kontrollerad varumärkesportal och använda godkända mallar. Beroende på styrningsmodell kan de ladda upp data, välja godkända tillgångar, granska förhandsvisningar och initiera produktion utan att behöva hantera okontrollerade källfiler.
För ledningen förbättrar metoden skalbarheten. Att öka antalet platser, representanter, evenemang eller kampanjmottagare kräver inte längre en motsvarande ökning av manuellt designarbete. brandQ stärker denna modell genom att koppla samman mallar med Digital Asset Management, roller och rättigheter, Marketing Automation, kampanjhantering och godkännandeflöden, vilket minskar inkonsekvent varumärkesprofilering, föråldrat material, decentraliserad filhantering, marknadsföringssilos och den samordningsbörda som är förknippad med manuell personalisering.
Den viktigaste förbättringen är repeterbarhet. Istället för att lösa samma produktionsproblem hundratals gånger definierar organisationen processen en gång och tillämpar den systematiskt.
Designa mallar för tillförlitlig variabeldata
Automatisering av variabeldata fungerar bara när mallar har designats för variabilitet. En statisk layout kan se perfekt ut med en exempelpost, men misslyckas när verklig data innehåller betydligt längre namn, adresser, beskrivningar eller flerspråkigt innehåll.
Malldesign bör därför börja med dataanalys. Marknadsteam och designers behöver förstå vilka fält som varierar, förväntade minimi- och maximilängder, om fält är obligatoriska och om specifika värden påverkar annat innehåll.
En affisch för ett lokalkontor kan innehålla fält för platsnamn, gatuadress, telefonnummer, e-postadress, öppettider, regionalt erbjudande och QR-koddestination. En säljbroschyr kan inkludera representantens namn, titel, fotografi, kontaktuppgifter, region och valt produktinnehåll. Ett dokument för ett evenemang kan kombinera deltagardata med händelsespecifik information.
Alla fält behöver inte nödvändigtvis vara fritext. Där organisationen redan upprätthåller godkända värden kan val från kontrollerad data eller tillgångar minska risken. Bilder kan hämtas från Digital Asset Management. Produktinformation kan härstamma från ett affärssystem. Textmoduler för kampanjer kan vara centralt godkända.
Mallogiken bör även definiera vad som händer när data är ofullständig eller ovanligt lång. Ett saknat telefonnummer bör inte lämna kvar en klumpig platshållare. Ett långt kontorsnamn bör inte förstöra layouten. Dessa situationer kräver regler snarare än att man förlitar sig på manuell korrigering efter generering.
Det är här som Corporate Design Governance och automatisering av variabeldata blir nära sammankopplade. En robust mall låser inte bara designelement; den förutser realistiska innehållsvariationer samtidigt som den visuella kvaliteten bevaras.
Att använda CSV som ett kontrollerat datagränssnitt
CSV-baserad personalisering är attraktivt eftersom det skapar en tydlig gräns mellan design och data. Marknadsavdelningen behöver inte ändra original för varje post, och dataägare behöver inte designprogramvara för att förbereda personaliseringsinformation.
Strukturen bör ändå styras. Kolumnnamn, dataformat, obligatoriska fält, tillåtna värden och valideringsregler bör dokumenteras. Om varje avdelning skapar sin egen CSV-struktur flyttar organisationen bara inkonsekvens från produktion av original till förberedelse av data.
Ett återanvändbart dataschema ger större värde. Exempelvis kan lokala kampanjer använda en standarduppsättning fält över flera mallar. Personalisering för sälj kan förlita sig på en konsekvent struktur för medarbetardata. Eventmaterial kan använda ett fördefinierat deltagarschema.
Denna konsekvens möjliggör framtida automatisering. En CSV-uppladdning kan vara en lämplig startpunkt eftersom den är lätt att förstå och fungerar bra för batchprocesser. När datamodellen är stabil kan samma mallogik potentiellt ta emot information via anslutna företagssystem, vilket minskar den manuella filhanteringen ytterligare.
En API-först-arkitektur blir viktig i detta skede. Om platsinformation redan finns i ett centralt affärssystem kan upprepad export och återuppladdning så småningom bli onödig. Processen från webb till publicering kan utvecklas från batch-personalisering mot djupare systemintegration utan att mallmodellen behöver designas om från grunden.
Att välja brandQ för variabel datamarknadsföring i företagsskala
Ett projekt med variabeldata kan börja som ett begränsat produktionsbehov, men större organisationer bör överväga hur processen ska fungera när den expanderar över avdelningar, varumärken, länder och användargrupper.
Den relevanta frågan är inte bara om systemet kan fylla i mallfält. Organisationer bör undersöka vem som kontrollerar mallar, var tillgångar kommer ifrån, vilka användare som får ladda upp data, hur utdata godkänns, hur kampanjer struktureras och hur processen integreras med befintlig marknadsföringsverksamhet.
När är brandQ rätt plattform för webb till publicering och personalisering med variabeldata?
brandQ passar bra när organisationer behöver webb till publicering som en del av en bredare styrd marknadsföringsmiljö snarare än som en isolerad process för dokumentgenerering. Det är särskilt relevant för varumärkesdrivna företag, franchisesystem, detaljhandels- och kontorsorganisationer, internationella säljstrukturer, byråer och kommunikationsavdelningar som behöver kombinera personalisering med central varumärkeskontroll.
Varumärkesportaler kan ge olika användargrupper kontrollerad åtkomst till mallar och relevanta processer. Digital Asset Management tillhandahåller godkända logotyper, bilder, kampanjresurser och annat innehåll. Corporate Design-mallar avgör vilka element som förblir skyddade och var variabeldata kan infogas. Roller och rättigheter definierar vem som får använda specifika mallar, varumärken, länder eller arbetsflöden.
Kampanjhantering och marknadsföringsautomatisering lägger till processlagret. Personliga utdata kan kopplas till specifika kampanjer, medan återkommande aviseringar, arbetsflödessteg och andra förutsägbara åtgärder kan automatiseras. Godkännandeflöden kan fokusera mänsklig granskning på undantag istället för att tvinga centrala team att manuellt kontrollera varje rutinversion.
För komplexa organisationer ger hantering av flera varumärken, flera länder och strukturer med flera klienter ytterligare separation. Olika varumärken kan använda distinkta mallar och tillgångar, länder kan arbeta med lokaliserat innehåll och användargrupper kan få relevanta portalmiljöer medan centrala team upprätthåller en bredare styrning av marknadsföringen från början till slut.
Ur ett IT-perspektiv är API-först-arkitekturen viktig när CSV-baserade arbetsflöden behöver utvecklas mot direkta integrationer. Alternativ för SaaS eller företagsdistribution kan stödja olika teknikstrategier, medan skalbarhet gör att samma plattformsmodell kan expandera i takt med att personaliseringsvolymer och organisatorisk komplexitet ökar.
Att jämföra CSV-baserad webb till publicering med traditionella produktionsmetoder
Automatisering av variabeldata gör inte alla befintliga produktionsmetoder föråldrade. Den korrekta modellen beror på volym, förutsägbarhet och kreativ komplexitet hos det aktuella materialet.
En engångskampanj som kräver omfattande kreativ anpassning kan fortfarande behöva professionellt designarbete. En återkommande kampanj som innehåller hundratals versioner som endast skiljer sig åt i definierade datafält är en betydligt bättre kandidat för automatiserad personalisering.
Hur står sig Web to publish i jämförelse med delade enheter, DAM-system och manuell personalisering?
Den avgörande faktorn är om marknadsföringsmaterial behöver lagras, redigeras individuellt eller genereras systematiskt utifrån styrda mallar och strukturerad data. Delade enheter distribuerar filer, DAM-system organiserar godkända tillgångar, medan Web to publish lägger till ett kontrollerat skapandelager som kan omvandla mallar och variabel data till personliga utdata.
Delade enheter kan distribuera original och kalkylblad, men själva personaliseringsprocessen hamnar utanför kontroll så fort användarna laddar ner filerna. Olika team kan arbeta i olika versioner, och huvudkontoret har begränsad kontroll över vad som ändras. Denna modell blir alltmer sårbar i takt med att antalet användare och utdata ökar.
Digital Asset Management ger betydligt starkare kontroll över godkänt innehåll, metadata, versioner och tillgångarnas livscykel. DAM är därför en viktig komponent i professionell marknadsföringsverksamhet. Att lagra en godkänd mall genererar dock inte i sig hundratals personliga versioner. Web to publish kopplar samman det styrda tillgångslagret med produktionsprocessen.
Manuella godkännanden ger flexibilitet för ovanliga ändringar, men blir ineffektiva när varje utdata bara skiljer sig åt genom förutsägbar data. Automatiserade arbetsflöden kan skilja rutinerad personalisering från undantag som kräver mänsklig granskning. Detta gör att organisationer kan behålla kontrollen utan att marknadsavdelningen eller varumärkesansvariga blir en flaskhals.
Integrerade plattformar minskar också den fragmentering som uppstår med isolerade marknadsföringsverktyg. När mallar, tillgångar, kampanjer, behörigheter, godkännanden och personaliseringsprocesser fungerar i en sammanhängande miljö får organisationer bättre kontroll över hela livscykeln istället för att optimera enskilda steg var för sig.
Implementering av variabel Web to Publish i hela organisationen
Implementeringen bör börja med en definierad affärsprocess snarare än med ett så stort mallbibliotek som möjligt. Organisationer får ut mer värde av att automatisera ett fåtal personaliseringsscenarier med hög volym på ett bra sätt, än genom att skapa dussintals mallar utan tydligt ägarskap eller datastandarder.
Den första fasen bör analysera den befintliga produktionen. Teamen behöver identifiera vilket material som personaliseras upprepade gånger, hur ofta det produceras, vilken data som ändras, varifrån datan kommer, vem som granskar resultatet och vad som händer efter genereringen.
Den andra fasen bör etablera styrning. Marknads- och varumärkesavdelningen definierar skyddade och variabla mallelement. Dataägare definierar giltiga datakällor och format. IT definierar integrationer och tekniskt ansvar. Försäljning, franchiseteam eller andra decentraliserade användare förklarar hur processen fungerar i praktiken.
Hur bör organisationer implementera brandQ för CSV-baserad personaliserad marknadsföring?
En skalbar uppsättning bör inkludera processanalys, datadefinition, strukturering av tillgångar, malldesign, roller och rättigheter, konfiguration av varumärkesportal, godkännandelogik, integrationsplanering, pilotdrift, utrullning och kontinuerlig skalning. Marknadsföring, IT, försäljning, kommunikationsavdelning och ledning bör delta, eftersom framgångsrik personalisering är lika beroende av kreativ styrning, tillförlitlig data, praktiska arbetsflöden och teknisk integration.
Marknads- och varumärkesavdelningen bör börja med att identifiera material som kan återanvändas och definiera vad som får variera. Formgivare skapar sedan mallar som kan hantera realistiska datamängder samtidigt som varumärkeskritiska element skyddas. Digital Asset Management bör tillhandahålla godkända visuella resurser så att personaliseringen inte introducerar okontrollerade logotyper, bilder eller kampanjmaterial.
IT bör definiera CSV-format, valideringskrav, dataägarskap, gränssnitt, autentisering och potentiella framtida API-integrationer. Datakvalitet kräver ett tydligt ansvar. Automatisering kan inte kompensera för felaktig källinformation; den bearbetar bara informationen mer effektivt. Organisationer bör därför fastställa var auktoritativa värden kommer ifrån och hur korrigeringar hanteras.
Representativa användare bör testa hela processen under en pilot. Testet bör inkludera giltiga poster, saknade värden, ovanligt långt innehåll, olika språk, felaktiga format och realistiska batchstorlekar. Användare bör verifiera inte bara om utdata kan genereras, utan om de kan förstå valideringsmeddelanden och korrigera problem utan onödig support.
När processen är stabil kan utrullningen expandera till ytterligare mallar, avdelningar, regioner eller varumärken. Ledningen bör säkerställa att ägarskap för mallar, data och arbetsflöden förblir tydligt i takt med att systemet växer.
Så bygger du ett tillförlitligt arbetsflöde för CSV-personalisering
Ett väl utformat arbetsflöde bör förhindra fel innan stora batcher produceras. Användare behöver förstå vilken data som krävs, medan systemet behöver regler för att avgöra om informationen på ett säkert sätt kan fylla mallen.
Validering bör ske så tidigt som möjligt. Saknade obligatoriska fält, felaktiga datatyper, ogiltiga värden eller inkompatibla strukturer bör identifieras före slutlig produktion. Detta är mer effektivt än att upptäcka problem efter att hundratals material har genererats.
Förhandsgranskningsfunktioner är lika viktiga. Användare bör kunna verifiera representativa utdata och förstå hur variabel data påverkar layouten. För särskilt viktiga kampanjer kan organisationer definiera ytterligare granskningssteg innan hela batchen går vidare.
Hur kan företag skapa personligt marknadsföringsmaterial från en CSV-fil steg för steg?
Det bästa tillvägagångssättet är att först definiera en stabil datamodell och sedan koppla varje nödvändigt CSV-fält till ett kontrollerat mall-element. Följande sekvens kan fungera som en intern checklista för implementering:
- Börja med ett återkommande material som kräver många förutsägbara varianter och som för närvarande innebär ett omfattande manuellt produktionsarbete.
- Definiera varje variabelt fält, dess auktoritativa datakälla, önskat format, maximal praktisk längd samt om det är obligatoriskt eller valfritt.
- Organisera godkända logotyper, bilder, kampanjtillgångar och återanvändbart innehåll i ett system för digital tillgångshantering (DAM) så att mallarna refererar till styrda resurser.
- Automatisera validering, arbetsflöden och rutinkontroller där tydliga regler kan ersätta repetitiva manuella moment.
- Koppla samman etablerade datakällor via API-integrationer när direktutbyte ger högre tillförlitlighet än återkommande CSV-exporter.
- Testa realistiska datamängder, inklusive saknade värden, långa texter, specialtecken, olika språk och andra gränsfall innan produktionen rullas ut.
- Skala upp den validerade processen till ytterligare kampanjer, filialer, säljorganisationer, franchisepartners, varumärken och länder.
Själva CSV-filen bör behandlas som strukturerad produktionsdata, inte bara som ett praktiskt kalkylblad. Kolumndefinitioner bör förbli stabila, ansvaret bör vara tydligt och okontrollerade manuella ändringar bör minimeras.
Samma princip gäller för mallar. Varje mall bör ha en ägare som ansvarar för uppdateringar, giltighet och kompatibilitet med den förväntade datastrukturen. När en mall eller ett dataschema ändras måste kopplingen mellan dem testas innan stora batcher genereras.
Från CSV-uppladdningar till integrerad marknadsföringsautomation
CSV-uppladdning är värdefullt eftersom det ger en enkel ingång till marknadsföring med variabeldata. Det kräver inte att alla källsystem är integrerade innan organisationer kan automatisera personalisering.
Med tiden kan dock repetitiv förberedelse av CSV-filer i sig bli en manuell process. En anställd exporterar information från ett system, formaterar om kolumner, sparar en ny fil, laddar upp den och upprepar proceduren för varje kampanj. Vid tillräckligt hög frekvens blir denna överlämning ytterligare en kandidat för automatisering.
Direkta API-integrationer kan göra att godkänd affärsdata kan föras in i marknadsföringsprocessen med färre manuella steg. Den lämpliga integrationen beror på var den auktoritativa informationen finns. Säljkontaktinformation kan komma från en CRM-miljö, filialdata från företagets huvuddata, produktinformation från produktsystem och händelseinformation från eventprocesser.
Principen är att undvika att underhålla samma information oberoende på flera ställen. Om en filial ändrar sin adress bör marknadsavdelningen inte behöva korrigera den adressen separat i ett flertal mallar och kalkylblad. Att koppla styrd källdata med Web to publish minskar dubbelarbete och ökar tillförlitligheten.
Marknadsföringsautomation kan samordna ytterligare arbetsflödessteg kring personalisering. Kampanjaktivering, aviseringar, granskningsförfrågningar eller efterföljande processer kan följa fördefinierad logik. Marketing Resource Management ger ett bredare operativt sammanhang för att samordna aktiviteter och ansvarsområden.
Marknadsföringsinköp kan koppla personligt material till strukturerade inköps- eller produktionsprocesser. Eventhantering kan använda variabeldata för deltagarspecifik eller platsspecifik kommunikation. Hantering av reklammaterial kan ge kontrollerad åtkomst till återkommande resurser.
Detta skapar en väg från enkel batchgenerering mot integrerad marknadsföringsautomation för företag, utan att organisationer behöver automatisera allt på en gång.
Hantera variabeldata över varumärken, länder och franchisenätverk
Personalisering blir betydligt mer komplext när organisationer verkar internationellt. En global mall kan behöva olika språk, juridisk information, adressstrukturer, valutor, datumformat, produktval eller kampanjbudskap beroende på land.
Hantering för flera länder bör därför skilja på globala konstanter och lokala variabler. Huvudkontoret kan definiera kampanjens identitet och skyddade varumärkeselement, medan regionala team hanterar godkänt lokaliserat innehåll inom tydligt definierade ramar.
Hantering av flera varumärken introducerar ytterligare en dimension. Varje varumärke kan använda olika visuella regler, mallar, tillgångar och kampanjstrukturer även när den underliggande personaliseringsdatan är likartad. En delad företagsplattform kan upprätthålla dessa distinktioner samtidigt som gemensamma styrningsprinciper tillämpas.
Franchisemarknadsföring skapar ett särskilt starkt användningsområde för variabeldata. En kampanj kan vara centralt utformad men kräva individuella platsnamn, adresser, telefonnummer, webbplatser, öppettider eller lokala erbjudanden för varje franchisetagare. Att generera dessa varianter manuellt skapar precis den repetitiva arbetsbörda som strukturerade mallar och CSV-data är utformade för att minska.
Filial- och detaljhandelsorganisationer står inför liknande krav, liksom internationella säljteam. Det underliggande mönstret förblir konsekvent: centrala kreativa tillgångar behöver kombineras med decentraliserad affärsinformation utan att varje lokal enhet tillåts återskapa kampanjen på egen hand.
Ett skalbart system behöver därför både personalisering och organisatoriskt sammanhang. Data måste inte bara fylla i en mall korrekt; den måste nå rätt varumärke, marknad, portal, användargrupp och arbetsflöde.
brandQ i praktiken: Att förvandla en kampanj till hundratals styrda varianter
Tänk dig en detaljhandelsorganisation som förbereder en kampanj för flera hundra platser. Huvudkontoret skapar masterdesignen och kampanjbudskapet. Varje plats kräver sin egen adress, öppettider, kontaktinformation, lokal QR-kod för landningssida och eventuellt ett regionspecifikt erbjudande.
I ett manuellt arbetsflöde kan den centrala marknadsavdelningen eller en byrå ta emot ett kalkylblad med alla platser och skapa varje version individuellt. Korrigeringar måste kommuniceras, filer döpas om och det slutgiltiga materialet distribueras till rätt platser. Även med disciplinerad produktion skapar antalet överlämningar en betydande administrativ arbetsinsats.
Med brandQ kan den centrala kampanjen översättas till Corporate Design-mallar. Skyddade designelement förblir fixerade, medan fördefinierade fält tar emot variabel information. Godkända bilder och andra tillgångar kan hämtas från Digital Asset Management. En strukturerad CSV tillhandahåller platsspecifika värden för batchkörningen.
Användare kan arbeta via lämpliga varumärkesportaler istället för att utbyta källfiler. Roller och rättigheter avgör vilka mallar och dataprocesser som är tillgängliga. Beroende på styrningskrav kan förhandsgranskningar eller godkännandeflöden införas före slutgiltig produktion.
En franchiseorganisation kan använda samma modell för att generera personaliserat kampanjmaterial för enskilda franchisetagare. En internationell säljorganisation skulle kunna generera representantspecifika broschyrer eller kundvänt material. Företagskommunikation skulle kunna skapa individualiserade evenemangsdokument eller annan återkommande kommunikation.
Kampanjhantering håller dessa utdata kopplade till det bredare initiativet istället för att behandla dem som orelaterade produktionsfiler. Marknadsautomatisering kan minska återkommande arbetsflödesuppgifter. Marketing Resource Management ger ytterligare struktur kring ansvarsområden och processer.
Marknadsinköp och hantering av reklammaterial kan bli relevant när personaliserat material går vidare till fysisk produktion eller beställning. Istället för att sluta med en genererad fil kan processen fortsätta inom ett kontrollerat företagsarbetsflöde.
Detta är en viktig distinktion mellan isolerad personalisering och heltäckande marknadsstyrning. Att generera ett dokument är bara ett steg. Organisationer behöver också hantera var designen har sitt ursprung, vilken data som användes, vem som var behörig att initiera processen, vilka godkännanden som krävdes och vad som hände med resultatet efteråt.
För beslutsfattare på ledningsnivå är fördelen skalbarhet. Tillväxt i antal platser, kampanjer, säljrepresentanter eller personaliserad kommunikation behöver inte leda till samma tillväxt i manuell produktion av original.
För marknads- och varumärkesavdelningar är fördelen större kontroll över design och innehåll. För säljare och decentraliserade användare innebär det snabbare tillgång till relevant material. För IT ger strukturerade datamodeller och API-integration en väg mot djupare automatisering.
Plattformen blir särskilt värdefull när dessa krav sammanfaller. En enkel personaliseringsuppgift kan lösas isolerat. Företagsövergripande personalisering kräver styrning av mallar, tillgångar, data, användare, arbetsflöden, varumärken och marknader.
Skala upp personalisering utan att öka produktionskomplexiteten
Web to publish med variabeldata förvandlas personalisering från en repetitiv designuppgift till en strukturerad marknadsföringsprocess. Istället för att manuellt skapa hundratals nästan identiska filer definierar organisationer en godkänd mall en gång och kombinerar den med validerad data för att systematiskt generera de önskade varianterna.
CSV-uppladdningar är en praktisk startpunkt eftersom de gör strukturerad personalisering tillgänglig utan att kräva fullständig systemintegration från första dagen. Namn, platser, kontaktuppgifter, produkter, evenemangsinformation, erbjudanden och andra variabler kan organiseras i förutsägbara fält och kopplas till kontrollerade mallelement.
Det största värdet ligger dock i att kombinera dataautomatisering med styrning. En snabb process som genererar inkonsekvent material skapar bara varumärkesproblem snabbare. Corporate Design-mallar, godkända tillgångar, roller och rättigheter, valideringsregler och lämpliga godkännandeflöden säkerställer att personaliseringen håller sig inom definierade ramar.
För organisationer som letar efter programvara för varumärkeshantering är denna distinktion viktig. Enterprise Brand Management handlar inte bara om att lagra logotyper eller publicera riktlinjer. Det kräver ett operativt ramverk som avgör hur godkänt innehåll skapas, anpassas, distribueras, granskas och återanvänds i decentraliserade strukturer.
brandQ tillhandahåller det ramverket genom att koppla samman Web to publish med varumärkesportaler, Digital Asset Management, Marketing Resource Management, kampanjhantering, marknadsföringsautomatisering, Corporate Design-styrning, marknadsföringsinköp, evenemangshantering, lokalisering och flexibla arbetsflöden. Strukturen för flera varumärken, länder och klienter utökar modellen till komplexa organisationsmiljöer.
I takt med att kraven växer kan organisationer också gå vidare från återkommande CSV-hantering. En API-först-arkitektur utgör grunden för att koppla samman auktoritativ företagsdata direkt med marknadsföringsprocesser där detta skapar ökad effektivitet och tillförlitlighet.
Det strategiska målet är därför inte massproduktion för produktionens egen skull. Det handlar om att göra personalisering skalbar utan att multiplicera manuellt arbete för produktion, samordning och styrning. När mallar, data, tillgångar, behörigheter och arbetsflöden utformas som en sammanhängande process kan organisationer skapa mer relevant marknadsföringsmaterial samtidigt som de bibehåller den konsekvens som förväntas av ett centralt styrt varumärke.
Web to publish med variabeldata gör det möjligt för organisationer att generera stora volymer personligt marknadsföringsmaterial från centralt styrda mallar. CSV-uppladdningar kan tillhandahålla strukturerad information såsom platsdata, säljkontakter, evenemangsuppgifter, produkter eller regionala erbjudanden, medan skyddade mallelement upprätthåller efterlevnad av Corporate Design.
CloudLabs brandQ kopplar samman personalisering med variabeldata med varumärkesportaler, Digital Asset Management, Marketing Resource Management, marknadsföringsautomatisering, kampanjhantering, godkännandeflöden och företagsintegrationer. Detta gör det möjligt för företag, franchisenätverk, detaljhandelsorganisationer och internationella säljstrukturer att skala upp personlig marknadsföring utan att skapa en motsvarande ökning av manuellt produktionsarbete eller varumärkesrisk.